トランスレーショナルリサーチのデータ解析とは?基礎研究を医療につなぐ実務を徹底解説
基礎研究で発見された遺伝子、タンパク質、細胞の働きが、そのまま新しい治療法や診断技術につながるわけではない。研究室で観察された現象が患者の体内でも再現されるのか、どの患者に効果が期待できるのか、安全性をどのように評価するのか。こうした問いにデータで答え、研究成果を実際の医療へ結び付けるのが、トランスレーショナルリサーチにおけるデータ解析の役割だ。
2026年現在、オミクス解析、バイオインフォマティクス、機械学習、リアルワールドデータ解析など、研究を支える手法は多様化している。一方で、データ量が増えれば医療への応用が自動的に進むわけではない。解析設計の不備、患者集団の違い、測定誤差、再現性の不足といった問題が、研究成果を臨床応用へ移す段階で大きな壁になる。日本医療研究開発機構(AMED)の橋渡し研究プログラムも、基礎研究から非臨床研究、臨床試験、実用化までの段階に応じた支援を位置付けている。
📌 【この記事の重要ポイントまとめ】
- 要点1:トランスレーショナルリサーチのデータ解析は、基礎研究の発見を臨床で検証できる仮説や診断・治療の候補へ変換する工程である。
- 要点2:オミクス解析やバイオマーカー探索では、統計的な有意差だけでなく、独立したデータでの再現性と臨床的な有用性を確認する必要がある。
- 要点3:臨床試験データ、電子カルテ、レセプトなどを統合する際は、データ品質、交絡、患者集団の違い、個人情報保護を考慮しなければならない。
【基本を整理】トランスレーショナルリサーチの仕組みとデータ解析の役割
トランスレーショナルリサーチとは、基礎研究で得られた科学的知見を、診断法、医薬品、医療機器、再生医療などの実用的な成果へ結び付ける研究活動を指す。日本語では「橋渡し研究」と呼ばれることが多い。
米国国立衛生研究所(NIH)の国立トランスレーショナル科学推進センター(NCATS)は、研究室、臨床現場、地域社会で得られた知見を、人々の健康を改善する介入へつなげるプロセスを説明している。そこでは、科学的な課題だけでなく、研究体制、資金、組織間連携などの運用上の障壁を解決することも重視されている。
データ解析は、この過程を横断する基盤技術だ。基礎研究では分子や細胞の変化を定量化し、前臨床研究では薬効や毒性を評価する。臨床研究では、患者における有効性、安全性、個人差を検証する。それぞれの段階でデータから得られる結論を明確にし、次の研究段階に進むための判断材料を提供する。
例えば、ある遺伝子の発現量が特定の疾患で高くなることが分かったとする。それだけでは、遺伝子が病気の原因なのか、病気の結果として変化したのか、治療標的として有効なのかは判断できない。追加の実験、患者検体の分析、独立した集団での検証を重ねる必要がある。
このように、橋渡し研究の目的は、単に基礎研究と臨床研究のデータを並べることではない。異なる段階のデータを関連付け、科学的な仮説を検証し、次の意思決定に必要な証拠を積み上げることにある。
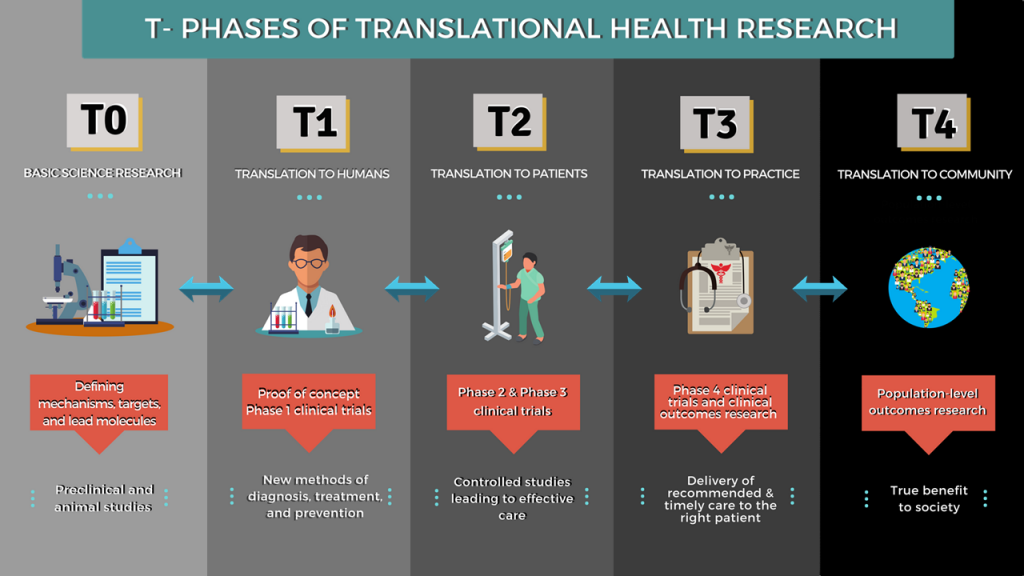
【核心】基礎研究の知見を臨床応用へどう結び付けるのか
トランスレーショナルリサーチのデータ解析では、最初に臨床上の課題を明確にし、その課題に答えるために必要な基礎研究と臨床研究を設計する。解析方法を先に選ぶのではなく、最終的に何を判断したいのかを起点にすることが重要だ。
1. 臨床上の課題から検証可能な仮説を立てる
出発点は、未解決の医療ニーズである。例えば、治療が効く患者と効かない患者の違いを明らかにしたいのか、病気を早期発見する検査を開発したいのか、副作用のリスクが高い患者を事前に識別したいのかによって、必要なデータも解析方法も異なる。
ここで設定する仮説には、対象集団、評価項目、測定方法、比較対象を含める。仮説が曖昧なまま大量のデータを解析すると、偶然見つかった相関を重要な発見と誤認するリスクが高まる。
2. 基礎研究と前臨床データで生物学的な妥当性を調べる
細胞実験や動物実験では、候補となる分子や薬剤が想定した作用を示すかを検証する。前臨床データ解析では、対照群との比較、用量反応関係、薬物動態・薬力学、安全性評価などを通じて、次の研究段階に進む根拠を確認する。
実験結果の評価では、測定値のばらつきだけでなく、独立した実験単位が何かを正しく把握する必要がある。例えば、同じ動物から採取した複数の検体を、すべて独立した動物のデータとして扱えば、実際よりも確実性が高いように見えるおそれがある。
3. 臨床データで患者における意味を検証する
基礎研究で有望だった候補が、患者でも同じ働きをするとは限らない。ヒトの病態は年齢、併存疾患、服薬、生活習慣、遺伝的背景などの影響を受けるためだ。
そこで、臨床試験や観察研究で候補の有効性、安全性、予測性能を評価する。研究段階に応じて、対象患者、評価時点、主要評価項目、欠測データの扱いを事前に定めることが求められる。
4. 独立したデータで再現性を確かめる
発見に使ったデータで良好な結果が得られても、未知の患者に同じ結果が当てはまるとは限らない。候補バイオマーカーや予測モデルは、別の患者集団、異なる施設、別の測定時期などで検証し、結果が再現されるかを確認する。
日本医療研究開発機構(AMED)の橋渡し研究プログラムは、研究シーズの発掘・育成から非臨床研究、臨床試験、実用化に向けた支援までを段階別に位置付けている。こうした研究開発の仕組みにおいて、データ解析は各段階の成果を評価し、継続、追加検証、計画変更といった判断を支える。
【比較表】研究段階別に見るデータ解析の手法と評価ポイント
トランスレーショナルリサーチでは、研究段階が変わるにつれて、解析の目的も評価すべきリスクも変化する。以下は、代表的なデータと手法を整理したものだ。
| 研究段階 | 主なデータ | 代表的な解析手法 | 確認すべきポイント |
|---|---|---|---|
| 基礎研究 | 遺伝子発現、タンパク質、細胞表現型、実験画像 | 統計解析、オミクス解析、画像解析、経路解析 | 実験条件、対照群、測定誤差、多重検定、再現性 |
| 前臨床研究 | 薬効、毒性、薬物動態、用量反応、動物実験 | 用量反応解析、PK・PD解析、群間比較、毒性評価 | 実験単位、無作為化、盲検化、種差、投与条件 |
| 臨床研究・臨床試験 | 患者背景、検査値、有効性、安全性、評価項目 | 回帰分析、生存時間解析、縦断データ解析、サブグループ解析 | 評価項目、交絡、欠測、解析対象集団、臨床的意義 |
| バイオマーカー開発 | 分子データ、検査値、診断、治療反応、転帰 | 特徴選択、ROC解析、感度・特異度評価、独立検証 | 測定の信頼性、判定基準、対象集団、臨床的有用性 |
| 実臨床での検証 | 電子カルテ、レセプト、疾患レジストリ、検査記録 | 傾向スコア法、回帰分析、生存時間解析、因果推論 | 交絡、選択バイアス、データ欠損、施設間差、追跡期間 |
| 予測モデルの開発・評価 | 臨床変数、画像、オミクス、複数データの統合情報 | 機械学習、内部検証、外部検証、較正評価 | データ漏洩、過学習、汎化性能、公平性、実装可能性 |
表の手法は代表例であり、すべての研究に同じ解析を適用するわけではない。研究目的、データの性質、症例数、測定方法、評価項目に応じて選択する必要がある。
特に重要なのは、統計的有意差と臨床的な意味を区別することだ。対象者が多ければ小さな差でも統計的に有意になる場合がある。一方、統計的に有意な結果であっても、診断精度を十分に改善しない、治療方針を変えない、安全性の向上につながらないのであれば、臨床現場での価値は限定的になり得る。
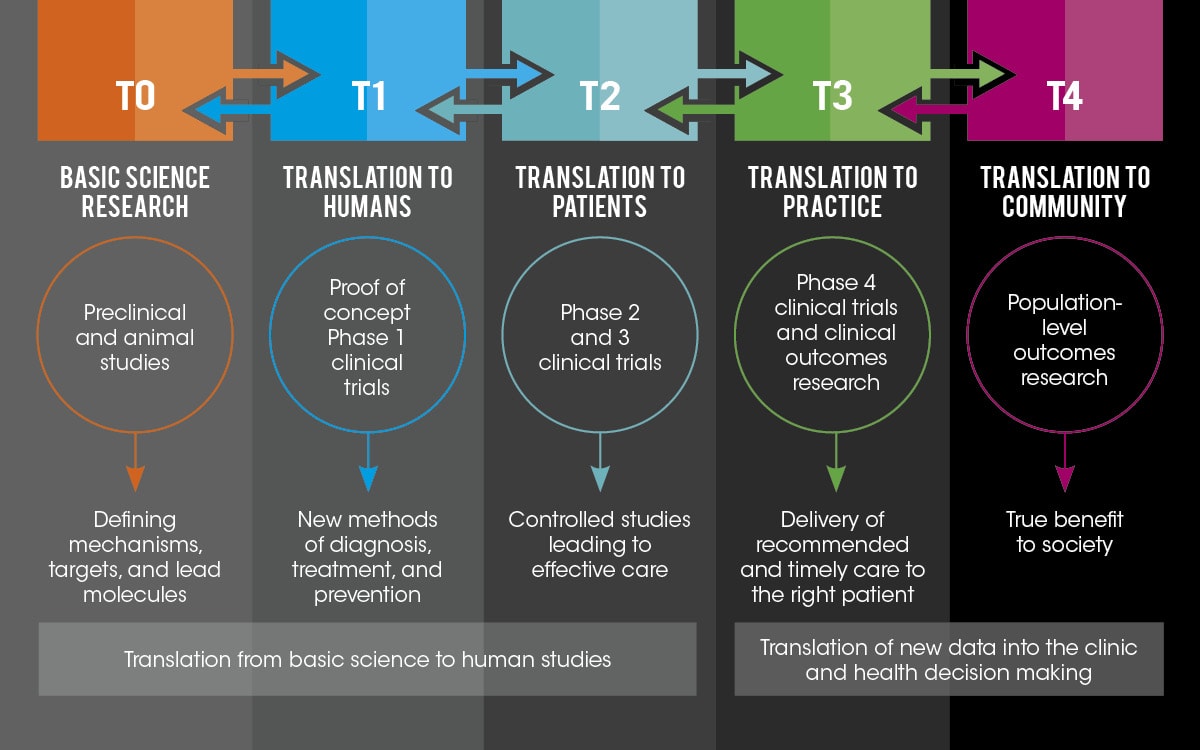
【技術解説】オミクス解析・マルチオミクス解析とバイオマーカー探索
トランスレーショナルリサーチで重要な役割を果たすのが、生命現象を分子レベルで捉えるオミクス解析だ。従来の研究が特定の遺伝子やタンパク質に注目するのに対し、オミクス解析では、多数の分子をまとめて測定し、疾患に関連するパターンや生物学的な仕組みを調べる。
オミクス解析で何が分かるのか
- ゲノミクス:遺伝的な変異や遺伝的背景と疾患との関係を調べる。
- トランスクリプトミクス:RNAの発現パターンから、細胞や組織の状態を評価する。
- プロテオミクス:タンパク質の量や状態を解析し、病態や治療反応に関連する変化を探る。
- メタボロミクス:代謝物を測定し、代謝経路や生理状態の変化を調べる。
これらのデータは、バイオインフォマティクスによって処理・解析される。具体的には、測定品質の確認、データの正規化、統計解析、特徴量の抽出、遺伝子やタンパク質の機能・経路の解釈などを組み合わせる。
マルチオミクス解析は情報を統合する技術
マルチオミクス解析は、ゲノム、RNA、タンパク質、代謝物など、異なる階層の情報を統合する手法だ。単一のデータでは捉えにくい病態の複雑さを理解し、疾患のサブタイプや治療反応の違いを説明する手掛かりを得られる。
例えば、遺伝子発現の変化だけでは病態との関連が明確でなくても、タンパク質や代謝物の情報を組み合わせることで、生物学的な経路との整合性を検討できる場合がある。ただし、異なる測定技術のデータを統合すれば、必ず解析精度が上がるわけではない。
測定装置、検体の保存条件、実験日、施設などの違いによるバッチ効果や、データごとの欠測、測定単位の違いを適切に扱う必要がある。さらに、変数の数に対して症例数が少ない場合、偶然の相関を拾う過学習が起きやすい。
バイオマーカー探索で押さえるべき3つの評価
バイオマーカーとは、正常な生物学的過程、病的過程、または介入に対する反応などを示すために測定する指標である。診断、予後予測、治療反応の予測、安全性評価など、目的によって求められる性能は異なる。
候補を探索する際は、次の3つを区別して評価する。
- 分析的妥当性:測定法が目的の対象を正確かつ安定して測定できるか。
- 臨床的妥当性:測定結果が疾患や臨床的な状態と適切に関連しているか。
- 臨床的有用性:その情報を使うことで診断、治療選択、患者管理などが改善するか。
米国食品医薬品局(FDA)のバイオマーカー適格性評価プログラムでは、医薬品開発での使用目的(Context of Use)を明確にし、その目的に照らして測定の信頼性や解釈の妥当性を評価する考え方が示されている。バイオマーカー自体の適格性と、測定に用いる検査法の性能は、関連していても同じものではない。
したがって、候補分子が疾患群と対照群の間で有意差を示しただけでは、実用化の根拠として不十分だ。独立した患者集団での検証、判定基準の設定、既存の検査法との比較、実際の診療で役立つかどうかの評価まで見通す必要がある。
【臨床応用の最前線】臨床試験データ解析・リアルワールドデータ・機械学習
基礎研究で見つかった候補を医療へつなぐには、分子レベルの知見を患者の状態や治療成績と結び付けなければならない。そのため、臨床試験データ解析、リアルワールドデータ解析、医療ビッグデータの統計解析が重要になる。
臨床試験データ解析では何を検証するのか
臨床試験では、あらかじめ定めた評価項目に基づいて、有効性や安全性を検証する。解析では、無作為化比較試験か観察研究かといった研究デザインを踏まえ、比較対象、解析対象集団、追跡期間、欠測データの処理方法などを適切に定める。
また、治療効果の平均値だけでは、個々の患者における効果の違いが分からない場合がある。年齢、疾患の重症度、遺伝的背景、併存疾患などによる差を調べるサブグループ解析も考えられるが、事後的に多数の比較を行うと、偶然の結果を見つけやすくなる。解析計画と探索的な分析を明確に区別することが大切だ。
リアルワールドデータ解析の可能性と限界
リアルワールドデータ(RWD)は、日常診療などで収集される医療情報を指す。電子カルテ、レセプト、疾患レジストリ、検査記録などが代表例であり、通常の臨床試験だけでは把握しにくい患者集団や、長期的な治療経過を分析する際に活用できる。
一方、日常診療のデータは、研究目的に合わせて収集されたものとは限らない。検査が行われる患者に偏りがある、診断コードの運用が施設によって異なる、治療を選択した背景が記録に十分残らないといった問題がある。
例えば、ある薬を使用した患者の転帰が良好だったとしても、薬の効果だけで説明できるとは限らない。患者の重症度、年齢、併存疾患、医師による治療選択などが結果に影響する可能性がある。こうした交絡を考慮し、研究目的に合った比較設計と感度分析を行う必要がある。
医薬品医療機器総合機構(PMDA)は、リアルワールドデータに関連するガイダンスや信頼性保証に関する情報を公開している。規制上の判断にデータを用いる場合には、単にデータ量が大きいことではなく、データの由来、収集方法、欠測、追跡可能性、解析の妥当性などが重要になる。
機械学習による医療データ分析は何を変えるのか
機械学習は、多数の変数から予測に有用なパターンを学習し、診断支援、治療反応の予測、患者のリスク分類などに活用できる。オミクスデータと臨床情報を組み合わせることで、従来の単純な指標では捉えにくい特徴を抽出できる可能性もある。
ただし、学習データに対する性能が高いことと、実際の診療で信頼できることは別問題だ。学習データと評価データに同じ患者の情報が混入するデータ漏洩、特定施設の特徴を学習することによる偏り、対象集団の変化による性能低下などに注意しなければならない。
評価では、識別性能だけでなく、予測確率と実際の発生割合が一致するかを示す較正、施設や患者属性による性能差、臨床上の意思決定に与える影響も確認する。
2024年4月16日にBMJで公表されたTRIPOD+AI声明は、回帰モデルと機械学習モデルの双方を対象に、臨床予測モデルの研究内容を透明性高く報告するための指針を示した。AIを使ったという事実だけでは研究の質は保証されず、データ、手法、検証方法、限界を明らかにすることが必要だ。
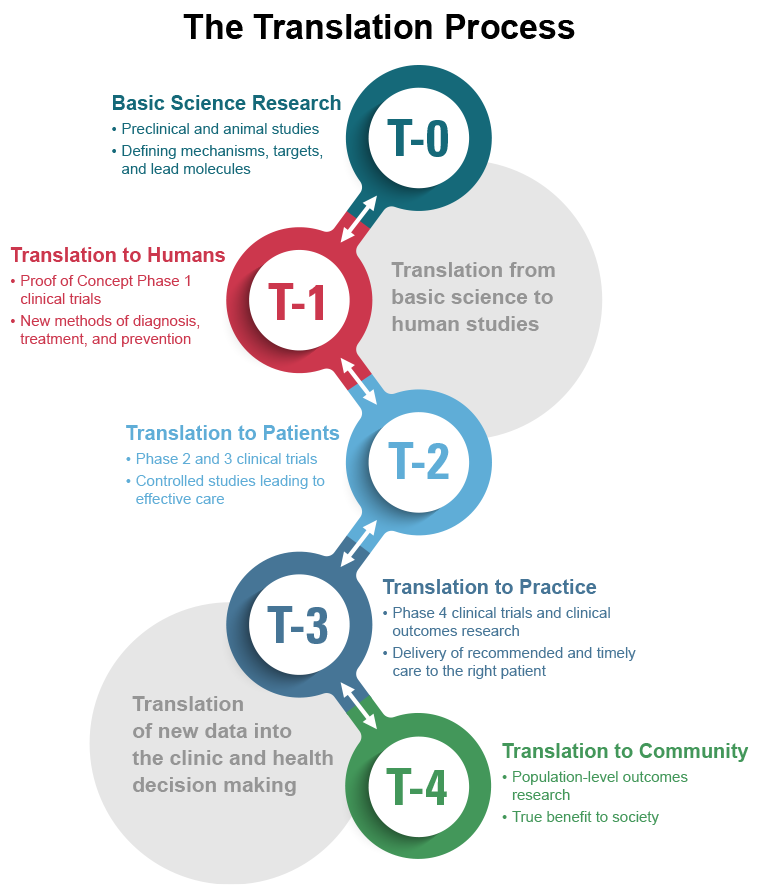
【見落とし厳禁】研究データの品質管理と再現性を左右する課題
トランスレーショナルリサーチでは、高度な解析アルゴリズムを導入する前に、入力データがどのように生成され、処理され、管理されているかを確認する必要がある。品質の低いデータを複雑なモデルに投入しても、信頼できる結論が得られるとは限らない。
測定条件とデータ形式をそろえる
研究施設ごとに、検体の採取・保存方法、測定装置、試薬、測定時点、検査項目の定義が異なれば、観察された差が疾患によるものなのか、測定条件によるものなのか判断しにくくなる。
このため、標準作業手順書(SOP)、共通のデータ辞書、メタデータ、単位やコードの統一、品質管理用の検体などを活用する。複数施設のデータを統合する場合は、施設差や測定バッチの影響を評価し、必要に応じて補正方法を検討する。ただし、補正によって本来の生物学的な差まで消してしまわないよう、処理前後の結果を比較することも重要だ。
欠測値、多重検定、過学習を管理する
欠測値は、単にデータが足りないという問題ではない。患者の重症度や医師の判断によって特定の検査が実施されにくい場合、欠測そのものが偏りを生むことがある。欠測の発生状況と理由を調べ、研究目的に適した方法を選ぶ必要がある。
また、オミクス解析では数千から数万の特徴量を同時に調べることがある。多数の仮説検定を行えば、偶然に有意な結果が得られる可能性が高まるため、適切な多重検定補正や偽発見率の管理が欠かせない。
候補を絞り込んだ後は、探索に使ったデータとは独立した検証データで評価する。モデルの調整に使ったデータを、そのまま最終評価にも使う設計では、未知のデータに対する性能を過大評価するおそれがある。
研究データの再利用性を高めるFAIR原則
米国NIHなどが紹介するFAIRデータ原則は、研究データを見つけやすく(Findable)、適切な条件下でアクセスでき(Accessible)、相互運用可能で(Interoperable)、再利用しやすい(Reusable)状態にする考え方だ。
実務では、データセットの識別情報、変数の定義、収集方法、解析コード、使用したソフトウェアとバージョン、除外基準、前処理の手順などを記録する。研究結果だけでなく、結果を得るまでの手順を追跡できる状態にしておくことが、再解析や第三者による検証を支える。
ただし、データ共有は無条件に行えばよいわけではない。医療情報には個人のプライバシーや研究参加者の権利に関わる情報が含まれるため、適切な匿名化・仮名化、アクセス制御、利用目的の管理、倫理審査や同意条件への配慮が必要となる。
基礎研究から臨床応用への課題は技術だけではない
橋渡し研究が停滞する原因は、解析技術の不足に限らない。研究者が目指す科学的な発見と、臨床現場が必要とする診断・治療の要件が一致していない場合もある。さらに、製造可能性、測定コスト、規制上の要件、知的財産、研究資金、専門人材の確保などが実用化を左右する。
NCATSが示すトランスレーショナルサイエンスの考え方でも、分野横断的なチーム形成、再現性のある研究、患者や地域社会との連携、研究の進捗に応じた意思決定が重視されている。データ解析の専門家だけで結論を出すのではなく、基礎研究者、臨床医、統計家、バイオインフォマティクス研究者、データ管理担当者などが共通の評価基準を持つことが、研究成果を医療へ届けるための条件となる。
【プロの結論】研究成果を医療につなぐための判断基準
トランスレーショナルリサーチのデータ解析で本当に評価すべきなのは、複雑な手法を使ったかどうかでも、発見された候補の数でもない。得られた結果が研究目的に答えているか、独立したデータで再現できるか、臨床現場の意思決定に役立つかという3つの視点だ。
実務で研究計画や解析結果を評価する際は、次の基準を確認したい。
- 研究目的と解析方法が一致しているか:対象集団、評価項目、比較対象、主要な仮説が明確になっているか。
- データの品質を説明できるか:検体の扱い、測定条件、欠測、バッチ効果、除外基準が記録されているか。
- 結果の再現性を確認しているか:探索データと検証データが区別され、独立した集団でも結果が確認されているか。
- 臨床的な価値が示されているか:統計的有意差にとどまらず、診断、治療選択、安全性、患者の転帰にどう影響するかが評価されているか。
- 次の研究段階への条件が明確か:追加実験、前臨床試験、臨床試験などに進むための根拠と、残る不確実性が整理されているか。
反対に、探索段階のデータだけで臨床的な有用性まで断定する研究や、AIの予測精度のみを強調して外部検証を行っていない研究は、慎重に評価する必要がある。
また、探索的研究で仮説が支持されなかった場合も、その結果は無価値ではない。適切に記録された陰性結果や失敗の情報は、同じ実験の重複を避け、次の研究計画を改善する材料になる。重要なのは、研究の成否にかかわらず、得られた知見を次の判断に活用できる状態で残すことだ。
研究者や研究支援担当者が解析計画を立てる際には、統計解析の担当者を研究の最終段階で加えるのではなく、仮説設定、実験設計、検体採取、データ管理の段階から連携することが望ましい。解析の質は、分析手法を選ぶ時点より前に始まっている。
【translational research data analysis】に関するよくある質問(FAQ)
Q1:トランスレーショナルリサーチのデータ解析とは何ですか? A1:基礎研究で得られた知見を、前臨床研究や臨床研究のデータと結び付け、診断法、治療法、医療機器などの開発に必要な証拠を積み上げるための解析です。統計解析、バイオインフォマティクス、オミクス解析、臨床データ解析などが含まれます。
Q2:橋渡し研究では、どのようなデータ解析手法を使いますか? A2:研究目的によって異なります。分子メカニズムの探索にはオミクス解析、薬効や毒性の評価には前臨床データ解析、有効性や安全性の検証には臨床試験データ解析、日常診療での評価にはリアルワールドデータ解析などを用います。必要に応じて機械学習や複数データの統合も検討します。
Q3:オミクス解析で見つけたバイオマーカーは、そのまま臨床で使えますか? A3:通常は、探索結果だけでは不十分です。測定法の信頼性、患者集団での関連性、独立したデータでの再現性、診断や治療の改善につながる臨床的有用性などを段階的に検証する必要があります。
Q4:機械学習を導入すれば、医療データの解析精度は向上しますか? A4:必ずしも向上するとは限りません。データの品質、症例数、特徴量の選択、学習と評価の分離、交絡や偏りへの対処が不適切であれば、過学習や性能の過大評価が生じます。外部検証や較正評価を含め、研究目的に適した方法を選ぶことが重要です。
Q5:研究データの再現性を高めるには何が必要ですか? A5:実験条件と測定手順の標準化、データ辞書やメタデータの整備、解析計画とコードの記録、適切な統計手法、独立した検証データの確保が基本です。研究データを再利用しやすくするFAIR原則も、透明性と再現性を支える考え方として役立ちます。
Q6:臨床試験データとリアルワールドデータはどう使い分けますか? A6:臨床試験データは、研究デザインに基づいて有効性や安全性を検証する際に重要です。リアルワールドデータは、日常診療での使用状況、幅広い患者集団での転帰、長期的な経過などを調べる際に役立ちます。両者には異なる強みと限界があり、研究課題に応じて使い分け、必要に応じて相互に補完します。
まとめ:今後の動向と失敗しないための判断基準
トランスレーショナルリサーチのデータ解析は、基礎研究の発見を臨床応用へ結び付けるための中核的な工程だ。オミクス解析やマルチオミクス解析による分子レベルの探索から、前臨床データ解析、臨床試験データ解析、リアルワールドデータ解析まで、各段階の情報を適切につなぐことで、研究成果を診断や治療の改善へ近づけられる。
今後は、機械学習による複雑なデータの統合や予測が研究を支える一方、データ品質、交絡、外部検証、再現性、個人情報保護の重要性も一層高まる。解析技術の高度化と同時に、研究の設計と管理を丁寧に行うことが求められる。
失敗しないための判断基準は明快だ。研究目的が明確であること、解析結果が再現できること、そして臨床上の意思決定に役立つこと。この3点を満たすように研究を設計し、データを管理し、段階ごとに検証することが、基礎研究の知見を患者に届く医療へ変えるための実務の要点である。 (出典: translational research data analysis(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
